Jev vs KCP: no es un versus
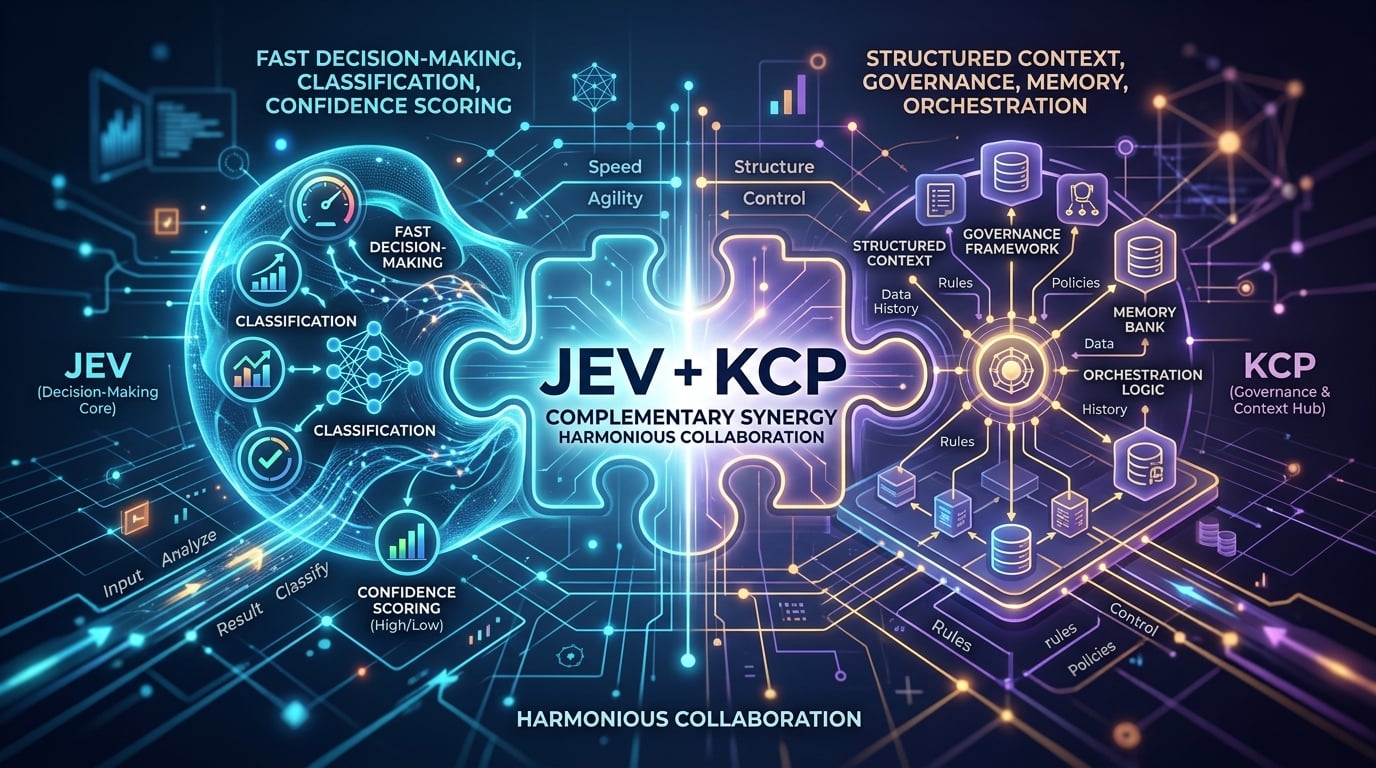
En corto: no elijas uno. Hacen trabajos distintos.
Jev —o un modelo de decisión similar— puede tomar un input y producir una decisión estructurada: una categoría, un score, una probabilidad o una opción de un conjunto cerrado.
KCP no clasifica ese texto. Su función está más cerca de declarar qué conocimiento, habilidades, procedimientos y reglas son válidos, cuáles están vigentes y bajo qué condiciones pueden utilizarse.
Y hay una tercera pieza que no conviene olvidar:
Una decisión no es lo mismo que una autorización, y una confianza no es lo mismo que una evidencia.
Si los ponemos al mismo nivel, parece que la IA aprueba un crédito o una póliza.
No necesariamente.
Primero están las reglas y el contexto autorizado. Después puede venir una decisión estructurada. Luego una política puede determinar qué hacer con ella. Y finalmente debe quedar evidencia de lo ocurrido.
Un 0.82 no es una firma.
KCP: https://github.com/Cantara/knowledge-context-protocol
1. Cuatro preguntas, no cuatro productos que se pelean
Cuando hablamos de AI Agents aparecen cada vez más siglas:
LLM, RAG, MCP, KCP, A2A, Skills, Playbooks, Jev...
Es fácil pensar:
¿Cuál reemplaza a cuál?
Creo que es una pregunta equivocada.
Es mejor preguntar:
¿Qué problema resuelve cada pieza?
| Pieza | En cristiano | En una clínica |
|---|---|---|
| LLM | ¿Cómo razono o genero una respuesta? | La médica piensa y explica |
| RAG | ¿Qué documentos parecen relevantes? | Revisar el archivo |
| KCP | ¿Qué conocimiento manda, está vigente y puedo utilizar? | El protocolo de este año, no el de 2024 |
| MCP | ¿A qué sistemas y herramientas puedo acceder? | Historia clínica, laboratorio, kardex |
| A2A | ¿Se lo paso a otro agente? | Interconsulta a farmacia |
| Skills / Playbooks | ¿Cómo se ejecuta este procedimiento? | La guía para tratar un caso específico |
| Jev / modelo de decisión | Dado este input permitido, ¿qué decisión estructurada corresponde? | ¿Farmacia, calidad o revisión humana? |
Una forma todavía más sencilla:
MCP       → ¿A qué puedo acceder?

KCP       → ¿Qué conocimiento/regla es válido?

Skills    → ¿Qué sé hacer?

Playbooks → ¿Cómo se ejecuta un procedimiento?

A2A       → ¿Con qué otro agente colaboro?

Jev       → ¿Qué decisión estructurada corresponde?

Audit     → ¿Qué ocurrió y puedo demostrarlo?
No son necesariamente competidores.
Son piezas diferentes de una arquitectura de agentes.
2. El dibujo fácil — y por qué puede engañar
Cuando alguien pide:
"Dibújame el stack de Agentic AI"
es tentador hacer esto:
                    AGENT
                      │
          ┌───────────┼───────────┐
          │           │           │
         KCP         MCP         A2A
          │           │           │
          └───────────┼───────────┘
                      │
                     Jev
                      │
                    ACTION
Se ve bonito.
Pero tiene un problema:
parece que Jev está debajo de KCP, MCP y A2A como si fuera otra capa del mismo tipo.
No necesariamente.
Una arquitectura más útil conceptualmente sería:
                         AGENT
                           │
             ┌─────────────┼─────────────┐
             │             │             │
            KCP           MCP           A2A
             │             │             │
        conocimiento      tools        agentes
        y gobierno        y datos      externos
             │
             ▼
      contexto autorizado
             │
             ▼
       MODELO DE DECISIÓN
        Jev / LLM / otro
             │
             ▼
       decisión estructurada
       choice + score + etc.
             │
             ▼
        POLICY / GATE
             │
        ┌────┴────┐
        ▼         ▼
      ACTION     HUMAN
        │
        ▼
       AUDIT
        │
        ▼
     EVIDENCE
La idea importante es:
El modelo puede proponer una decisión. La política determina qué se puede hacer con esa decisión.
3. ¿Qué es cada uno, sin folleto?
MCP — ¿a qué puedo entrar?
MCP es la capa de conexión con herramientas y recursos.
Por ejemplo:
Agent
  │
  ├── MCP → PostgreSQL
  ├── MCP → GitHub
  ├── MCP → SAP
  ├── MCP → REST API
  └── MCP → filesystem
Pregunta:
¿Qué herramientas y recursos tengo disponibles?
Yo lo veo como el enchufe.
KCP — ¿qué conocimiento manda?
KCP entra en otro problema.
Supongamos que RAG encuentra:
Política de crédito 2024
Política de crédito 2025
Política de crédito 2026
Encontrar documentos no significa saber cuál tiene autoridad.
KCP introduce una capa para declarar conocimiento y contexto gobernado:
Documento
   │
   ├── versión
   ├── vigencia
   ├── alcance
   ├── audiencia
   ├── autoridad
   └── relación con otros documentos
Y el ecosistema ha ido más allá del documento:
Knowledge
    ↓
Skills
    ↓
Playbooks
Por eso no lo describiría simplemente como "un inventario de documentos".
Es más preciso decir:
KCP es una capa de conocimiento y gobernanza para declarar qué conocimiento, capacidades y procedimientos están disponibles y bajo qué condiciones.
A2A — ¿se lo paso a otro agente?
A2A responde otra pregunta:
¿Cómo colaboro con otro agente?
Por ejemplo:
Customer Agent
      │
      ├──→ Credit Agent
      │
      ├──→ Fraud Agent
      │
      └──→ Shipping Agent
MCP:
Agent ↔ Tool
A2A:
Agent ↔ Agent
Son complementarios.
Skills y Playbooks — ¿cómo hago el trabajo?
Una cosa es saber que puedes acceder a una herramienta.
Otra es saber cómo utilizarla correctamente.
Por ejemplo:
Skill: "Analizar una solicitud de crédito"
Playbook:
Obtener datos
Validar identidad
Consultar política vigente
Evaluar riesgo
Solicitar revisión si corresponde
Registrar evidencia
Aquí empieza a aparecer una arquitectura mucho más interesante que simplemente:
"Tengo un chatbot conectado a una API."
Jev — ¿qué decisión estructurada corresponde?
Aquí está la diferencia fundamental.
Un LLM tradicional puede responder:
"Creo que este caso debería ser revisado por el área de fraude porque..."
Un modelo de decisión puede producir algo más cercano a:
{
  "decision": "fraud-review",
  "confidence": 0.82
}
O:
{
  "category": "A",
  "score": 82,
  "probability": 0.91
}
La idea de Jev es precisamente llevar el modelo hacia decisiones tipadas/probabilísticas en lugar de generación abierta.
Eso puede ser muy útil cuando el espacio de respuestas está controlado.
Pero aquí aparece una distinción fundamental.
4. "0% de alucinaciones" no significa "0% de errores"
Este punto merece mucha atención.
Una salida estructurada puede garantizar que el modelo solamente devuelva:
APPROVE
REFUSE
ESCALATE
Eso evita que el modelo invente una cuarta opción:
MAYBE-PERHAPS-APPROVE
Pero no significa que:
APPROVE
sea necesariamente la decisión correcta.
El propio análisis de Thor sobre Jev señala precisamente esta diferencia: la afirmación de "0% hallucination" se refiere a la garantía del esquema de salida, no a una garantía empírica de corrección.
Dicho de otra manera:
Schema correctness
        ≠
Decision correctness
Si las únicas opciones son:
APPROVE
REFUSE
el modelo siempre devolverá una de ellas.
Pero todavía puede equivocarse.
5. Y aquí aparece una palabra importante: calibración
Supongamos que el modelo responde:
decision = APPROVE
confidence = 0.82
La pregunta importante es:
¿Ese 0.82 significa realmente algo?
¿Significa que acertará aproximadamente el 82% de las veces?
¿O simplemente es un número que el modelo produce con mucha seguridad?
Para responderlo necesitamos datos.
Por ejemplo:
Confidence       Resultado real

0.50 – 0.59      58% correctas
0.60 – 0.69      67% correctas
0.70 – 0.79      75% correctas
0.80 – 0.89      84% correctas
0.90 – 0.99      92% correctas
Entonces podríamos empezar a hablar de una confianza calibrada.
Pero si todas nuestras decisiones son:
0.85
0.87
0.91
0.89
0.90
0.88
y nunca tenemos suficientes casos con otros niveles de confianza, no podemos saber realmente si el número está calibrado.
Eso es exactamente una de las cosas interesantes que descubrió Thor al auditar su propio sistema.
Su gateway llevaba meses produciendo decisiones tipadas, confidence y referencias a reglas. Pero cuando intentaron comprobar si el confidence realmente predecía la corrección, descubrieron que sus propios datos todavía no permitían responderlo.
Y esa es una lección que me parece mucho más importante que cualquier benchmark:
Un número de confianza necesita evidencia.
6. Un 0.82 no es una firma
Esta frase merece su propia sección.
Podemos tener:
decision = APPROVE
confidence = 0.82
Incluso podemos firmarlo criptográficamente.
Eso nos permite demostrar:
"El sistema produjo esta decisión con este valor."
Pero no demuestra:
"La decisión era correcta."
Son cosas diferentes.
Firma
  │
  ▼
Prueba de lo que ocurrió

Calibración
  │
  ▼
Evidencia sobre qué tan confiable es el número

Política
  │
  ▼
Qué podemos hacer con esa decisión
Por eso una arquitectura de agentes empresarial necesita algo más que modelos.
Necesita gobernanza y evidencia.
7. El caso de Ana López
Imaginemos que tenemos una clínica.
Ana López está hospitalizada y llega este texto:
"Paciente presenta potasio elevado y está tomando medicación X."
Nuestro sistema podría tener:
RAG
Encuentra:
Protocolo 2024
Protocolo 2025
Protocolo 2026
KCP
Determina:
Protocolo 2026
vigente
aplicable a este tipo de caso
MCP
Permite consultar:
Historia clínica
Laboratorio
Medicamentos
Skill / Playbook
Define:
Analizar hiperpotasemia
A2A
Puede delegar:
Medical Agent
      │
      └──→ Pharmacy Agent
Modelo de decisión
Recibe el contexto autorizado:
decision = "pharmacy-review"
confidence = 0.82
Pero todavía falta una pregunta:
¿Qué hacemos con ese 0.82?
La política podría decir:
if confidence < 0.75
    → human review

if medication == high-risk
    → human review

if policy requires physician
    → human review
Entonces:
            KCP
             │
             ▼
     contexto autorizado
             │
             ▼
       modelo de decisión
             │
             ▼
      pharmacy-review
          0.82
             │
             ▼
          POLICY
             │
             ▼
       HUMAN REVIEW
             │
             ▼
           AUDIT
Ahora sí tenemos una arquitectura defendible.
8. Lo más interesante: la auditoría también puede equivocarse
Y aquí el artículo de Thor tiene una segunda lección todavía más interesante.
Al auditar sus decisiones, inicialmente encontraron:
21 decisiones escaladas
21 aparentemente pendientes
Parecía un problema importante.
Pero el script de auditoría estaba utilizando mal un identificador de correlación.
Al corregir la relación entre eventos, el resultado cambió.
Y posteriormente encontraron otro problema: algunas de las decisiones que parecían pendientes pertenecían a ejecuciones que ya habían terminado o sido abortadas.
La conclusión es brutalmente sencilla:
Un sistema de auditoría también necesita ser auditado.
Podemos tener:
Agent
  ↓
Decision
  ↓
Audit
y aun así equivocarnos.
Por eso no basta con:
"Tengo logs."
Hay que poder responder:
¿Qué versión de la política estaba vigente?
¿Qué conocimiento se utilizó?
¿Qué modelo produjo la decisión?
¿Qué input recibió?
¿Qué decisión propuso?
¿Qué confidence produjo?
¿Qué regla la justificó?
¿Quién autorizó la acción?
¿Qué ocurrió después?
¿Podemos reconstruir el proceso?
Eso es evidence.
9. Entonces, ¿Jev reemplaza a KCP?
No.
Pero tampoco diría simplemente:
"KCP y Jev son complementarios."
Eso es demasiado superficial.
La relación más interesante es:
             KNOWLEDGE
                 │
                KCP
                 │
                 ▼
       CONTEXTO AUTORIZADO
                 │
                 ▼
          DECISION MODEL
        Jev / LLM / otro
                 │
                 ▼
       DECISIÓN PROPUESTA
                 │
                 ▼
          POLICY / GATE
                 │
          ┌──────┴──────┐
          ▼             ▼
       ACTION         HUMAN
          │
          ▼
         AUDIT
          │
          ▼
       EVIDENCE
Por eso el título sigue siendo:
Jev vs KCP: no es un versus
Pero ahora agregaría:
En realidad, tampoco es solamente Jev + KCP. Hay una tercera dimensión: gobernar y demostrar qué ocurrió.
10. Si tu equipo programa — Java u otra cosa
Todo esto no depende de Java.
Pero para un equipo Java podría verse perfectamente así:
Spring AI / LangChain4j / Quarkus
              │
              ▼
          AI Agent
              │
       ┌──────┼──────┐
       │      │      │
      KCP    MCP    A2A
       │      │      │
       │      │      └── Agent B
       │      │
       │      └──────── APIs / DB / Tools
       │
       └────────────── Knowledge / Policies
              │
              ▼
        Decision Model
              │
              ▼
      Structured Output
              │
              ▼
          Policy Gate
              │
          ┌───┴───┐
          ▼       ▼
        Action   Human
          │
          ▼
      Audit Trail
Y aquí está la parte que más me interesa como arquitecto:
no estamos construyendo simplemente un chatbot.
Estamos construyendo un sistema donde:
Knowledge
    +
Tools
    +
Agents
    +
Decision
    +
Governance
    +
Evidence
forman una unidad.
11. Cómo lo contaría en diez minutos
Si tuviera que explicar todo esto rápidamente, usaría solamente estas preguntas:
1. ¿Qué puedo usar?
MCP
Agent → Tools / Data
2. ¿Qué conocimiento es válido?
KCP
Agent → Governed Knowledge
3. ¿Cómo hago el trabajo?
Skills / Playbooks
Agent → Procedure
4. ¿Con qué otro agente colaboro?
A2A
Agent ↔ Agent
5. ¿Qué decisión corresponde?
Jev / modelo de decisión
Input → Decision + Score
6. ¿Qué puedo hacer con esa decisión?
Policy / Governance
Decision → Action / Human
7. ¿Cómo demuestro lo que pasó?
Audit / Evidence
Action → Trace → Evidence
Y ahí aparece una arquitectura mucho más completa:
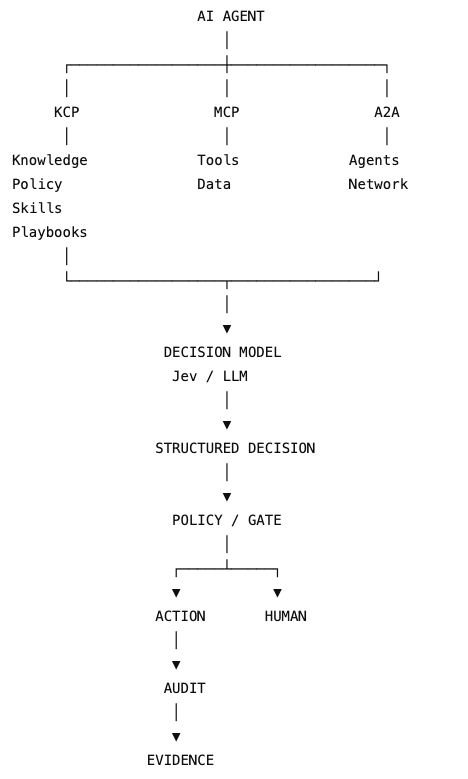
Cierre
Mi conclusión después de mirar Jev y KCP es que la pregunta:
"¿Jev o KCP?"
no es la pregunta que deberíamos hacernos.
La pregunta interesante es:
"¿Qué necesita un agente para conocer, decidir, actuar y poder defender después lo que hizo?"
Ahí cada pieza tiene un papel diferente.
MCP conecta al agente con herramientas y datos.
KCP ayuda a gobernar el conocimiento, las capacidades y los procedimientos que puede utilizar.
Skills y Playbooks describen cómo realizar determinados trabajos.
A2A permite colaborar con otros agentes.
Jev, o cualquier modelo de decisión estructurada, puede ayudar a convertir un input en una decisión tipada, un score o una probabilidad.
Pero hay una advertencia importante:
Un
confidence: 0.82no demuestra que la decisión sea correcta.
Para eso necesitamos datos, calibración y evidencia.
Y tampoco basta con tener un audit log.
El propio proceso de auditoría puede equivocarse.
Por eso, para mí, la arquitectura de agentes empresariales empieza a verse así:
KNOWLEDGE
    ↓
GOVERNANCE
    ↓
DECISION
    ↓
ACTION
    ↓
EVIDENCE
O, en una frase:
KCP ayuda a establecer qué vale y qué está permitido. Un modelo como Jev puede proponer qué decisión corresponde. La política determina qué puede ocurrir después. Y la evidencia permite demostrar qué ocurrió realmente.
No es un versus. Es un sistema.
Referencias
Thor Henning Hetland — We Already Run Jev. We Just Never Checked.
JoeDayz — Jev vs KCP: no es un versus
Jev AI — TypeSafe AI
Enjoy!
Joe