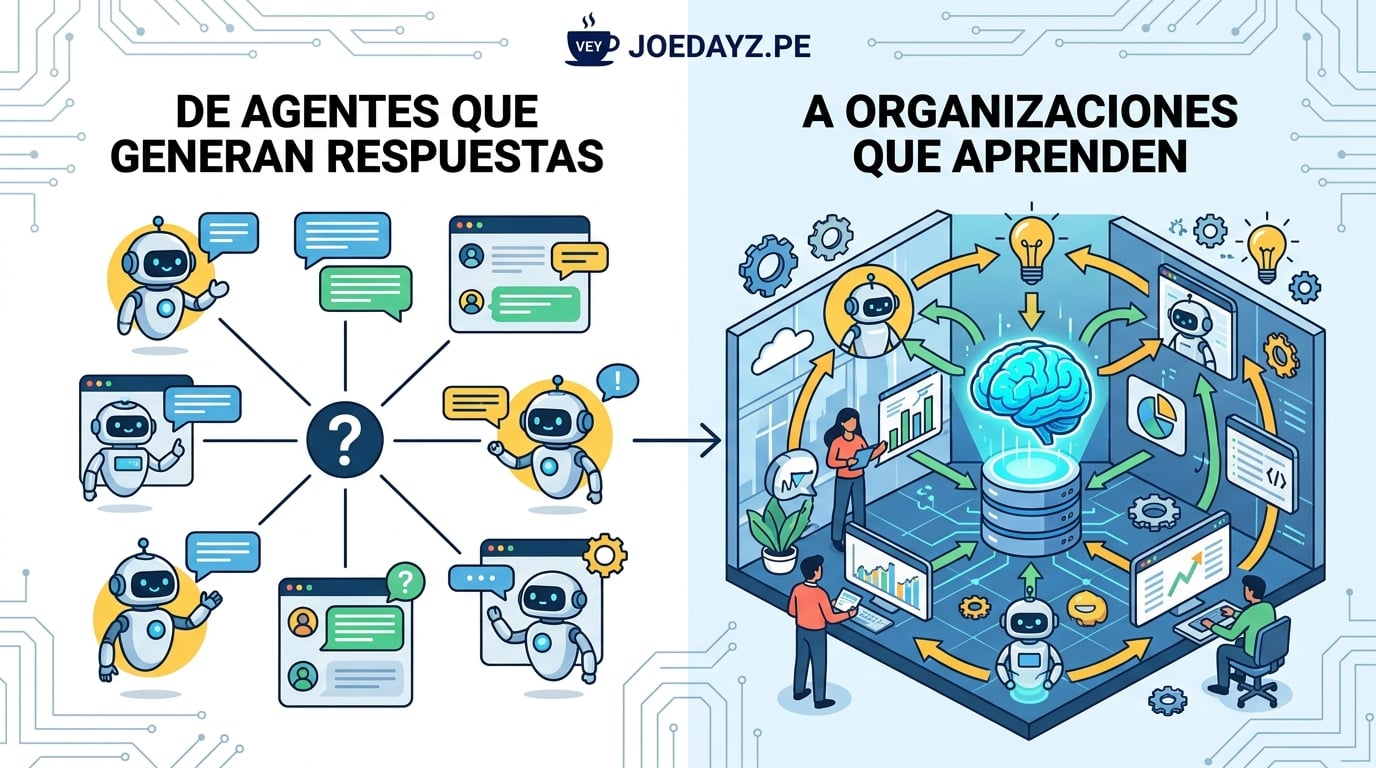
De agentes que generan respuestas a organizaciones que aprenden
Durante los últimos años hemos visto una evolución bastante rápida de la inteligencia artificial.
Primero aprendimos a conversar con modelos.
Después empezamos a utilizarlos para escribir código, analizar documentos, generar contenido y consultar información.
Ahora estamos entrando en una etapa diferente: los agentes.
Un agente no solamente responde. Puede consultar sistemas, utilizar herramientas, ejecutar procesos, modificar información y coordinarse con otros agentes.
Y aquí aparece una pregunta que considero mucho más importante que simplemente preguntar qué tan inteligente es nuestro modelo:
¿Cómo hacemos para que un agente pueda actuar con autonomía sin perder el contexto, la trazabilidad, la seguridad y el control humano?
Porque poner un LLM detrás de una API y darle permisos para ejecutar acciones no convierte automáticamente nuestro sistema en una arquitectura agentic.
De hecho, probablemente sea una receta bastante rápida para tener problemas.
Lo interesante es que, cuando empezamos a pensar seriamente en agentes, aparecen una serie de capacidades que antes podían parecer secundarias: memoria, conocimiento, herramientas, autorización, auditoría, verificación y aprendizaje.
Y todas terminan conectándose.
El problema no es que la IA produzca poco
Durante mucho tiempo el objetivo fue conseguir que la IA produjera más.
Más código.
Más documentos.
Más análisis.
Más respuestas.
Pero cuando tenemos varios agentes trabajando en paralelo aparece un problema diferente.
Supongamos que tenemos:
Agente A → analiza incidencias
Agente B → revisa código
Agente C → actualiza documentación
Agente D → ejecuta pruebas
Agente E → prepara cambios
La capacidad de producción puede crecer rápidamente.
Pero el humano sigue siendo uno.
Y ese humano tiene que:
revisar resultados;
tomar decisiones;
validar información;
aprobar acciones;
investigar errores.
Entonces el cuello de botella cambia.
Ya no es necesariamente:
"¿Cuánto puede producir la IA?"
Sino:
"¿Cuánto trabajo puede absorber y verificar una persona?"
Esto cambia completamente la arquitectura que necesitamos.
1. Un agente no puede empezar desde cero
Imaginemos que tenemos un agente excelente.
Tiene un buen modelo, buenas herramientas y acceso a nuestros sistemas.
Pero cada vez que iniciamos una sesión no sabe:
qué ocurrió ayer;
qué decisiones tomamos;
qué aprendimos;
qué solución fue descartada;
qué procedimiento funciona actualmente;
qué tiene permitido hacer.
Tenemos un agente muy capaz que todos los días parece ser su primer día de trabajo.
Por eso necesitamos diferentes tipos de conocimiento.
Una forma sencilla de verlo es:
Episódico
¿Qué ocurrió?

      ↓

Conocimiento
¿Qué creemos que es cierto?

      ↓

Skills
¿Cuál es el método validado?

      ↓

Playbooks
¿Cómo combinamos esos métodos?

      ↓

Gobernanza
¿Qué puede hacer el agente?
Esto cambia el ciclo de trabajo.
Ya no sería simplemente:
pregunta → respuesta
sino:
orientar
   ↓
recuperar contexto
   ↓
ejecutar
   ↓
verificar
   ↓
decidir
   ↓
aprender
   ↺
La siguiente ejecución comienza con lo aprendido en la anterior.
Ahí empieza a aparecer algo mucho más interesante que un chatbot:
memoria institucional.
2. Una respuesta no es conocimiento
Este punto parece obvio, pero se vuelve fundamental cuando dejamos que los agentes actúen.
Que un agente diga:
"El problema está en el servicio de pagos."
no significa que sea cierto.
Tenemos que poder distinguir:
Afirmación
    ↓
Fuente
    ↓
Evidencia
    ↓
Verificación
    ↓
Conocimiento confiable
Esto nos lleva al concepto de provenance o trazabilidad.
Cuando un agente toma una decisión importante deberíamos poder responder:
¿qué información utilizó?
¿de dónde salió?
¿qué regla aplicó?
¿qué versión del conocimiento utilizó?
¿quién autorizó la acción?
¿qué ocurrió finalmente?
Por ejemplo:
Agente:        billing-agent
Acción:        actualizar factura
Fuente:        ERP
Regla:         billing-update-v3
Autorización:  policy-17
Resultado:     success
Evidencia:     ...
Esto convierte una acción del agente en algo que podemos reconstruir posteriormente.
Pero hay una distinción importante:
Tener trazabilidad no significa tener razón.
Una firma puede demostrar que una acción ocurrió y quién la produjo.
No demuestra que la acción fuera correcta.
Por eso necesitamos combinar:
Provenance
+
Autorización
+
Evidencia
+
Verificación
3. No hagamos que el agente descubra lo que el sistema ya sabe
Aquí aparece otro problema.
Imaginemos un agente interactuando con una aplicación web:
Agente
  ↓
abre página
  ↓
busca botón
  ↓
interpreta texto
  ↓
hace clic
  ↓
comprueba resultado
El agente está intentando descubrir cómo funciona nuestro sistema a través de su interfaz.
¿Por qué no declarar directamente las capacidades?
Por ejemplo:
getCustomer(customerId)

createInvoice(customerId, items)

cancelInvoice(invoiceId)

approveRefund(refundId)
Ahora el agente sabe exactamente qué puede hacer y qué parámetros necesita.
La arquitectura cambia:
ANTES

Agente → UI → DOM → interpretación → acción


DESPUÉS

Agente → capacidad declarada → contrato → acción
Esto no solamente facilita el trabajo del agente.
También facilita:
testing;
autorización;
auditoría;
documentación;
observabilidad;
reutilización.
Y aparece una idea interesante:
La interfaz deja de ser necesariamente la fuente principal de información sobre lo que un sistema puede hacer.
Las capacidades pueden declararse explícitamente.
4. El agente necesita brazos, no solamente voz
Un chatbot tiene voz.
Un agente necesita brazos.
Es decir, necesita poder actuar:
Leer información
       ↓
Usar API
       ↓
Modificar información
       ↓
Ejecutar procesos
       ↓
Interactuar con otros sistemas
Pero aquí aparece un problema:
¿Qué acciones puede ejecutar?
No deberíamos responder:
"Las que permita su API key."
Eso es demasiado grueso.
La pregunta debería ser mucho más específica:
¿Este agente puede realizar esta acción, sobre este recurso, en este contexto y en este momento?
Por ejemplo:
crear PR                  → automático
ejecutar tests            → automático
modificar documentación   → automático

desplegar producción      → supervisión

eliminar base de datos    → aprobación explícita
transferir dinero         → aprobación explícita
La autonomía debería estar asociada a la acción, no solamente al agente.
5. La autonomía es un dial
Uno de los errores más comunes es pensar:
NO AUTÓNOMO ←→ AUTÓNOMO
En realidad necesitamos algo mucho más gradual:
Manual
   ↓
Automático con aprobación
   ↓
Automático con verificación
   ↓
Agente supervisado
   ↓
Agente autónomo
Y la posición depende de factores como:
riesgo;
reversibilidad;
alcance;
historial;
calidad de la evidencia;
autorización.
Un agente puede tener autonomía completa para limpiar ejecuciones de pruebas y necesitar aprobación humana para modificar producción.
No hay contradicción.
Son dos acciones diferentes.
6. Human-in-the-loop no significa aprobar todo
Aquí creo que aparece una de las ideas más importantes.
Durante mucho tiempo hemos pensado en Human-in-the-loop como:
Agente
  ↓
Humano
  ↓
Approve
Pero si hacemos esto para cada acción:
acción 1 → aprobar
acción 2 → aprobar
acción 3 → aprobar
acción 4 → aprobar
...
tenemos un problema.
El humano termina haciendo clic en "Approve" sin leer.
La seguridad se convierte en una ilusión.
Una arquitectura más interesante es:
                 ACCIÓN
                   ↓
          ¿Necesita juicio humano?
             ↙          ↘
           NO            SÍ
           ↓             ↓
       automático     humano correcto
                         ↓
                      decisión
Por ejemplo:
100 acciones
     ↓
95 → automáticas
 5 → revisión humana
El objetivo no es sacar al humano del sistema.
Es sacar del camino del humano todo lo que no necesita su juicio.
7. Permiso no significa relevancia
Esto también cambia la forma en que pensamos las notificaciones.
Una persona puede tener permiso para acceder a un proyecto.
Pero eso no significa que tenga que recibir todas las notificaciones de ese proyecto.
Tenemos dos conceptos diferentes:
PERMISSION
¿Puede verlo?

RELEVANCE
¿Necesita recibirlo?
Podemos agregar una tercera dimensión:
URGENCY
¿Necesita saberlo ahora?
Entonces:
Permission
     +
Relevance
     +
Urgency
     ↓
Delivery
Esto permite construir sistemas donde la mayoría de las cosas llegan como un resumen:
Digest

"Hay 27 elementos para revisar."
Y solamente las situaciones realmente importantes interrumpen:
Alert

"Esta acción requiere tu decisión."
Esto es importante porque la atención humana es un recurso limitado.
Si todo genera una alerta, ninguna alerta termina siendo realmente importante.
8. La confianza no se declara, se construye
Si queremos aumentar la autonomía de un agente necesitamos saber cuándo podemos confiar en él.
No basta con decir:
"Este modelo es muy bueno."
Necesitamos observar su comportamiento.
Historial
   ↓
Resultados
   ↓
Verificación
   ↓
Desviaciones
   ↓
Confianza
   ↓
Autonomía permitida
Y esa confianza tampoco debería ser permanente.
Si cambiamos:
el modelo;
las herramientas;
los datos;
las reglas;
el contexto;
el alcance;
tenemos que preguntarnos nuevamente:
¿La autorización y el nivel de autonomía siguen siendo válidos?
Un agente confiable para una tarea no necesariamente es confiable para otra.
9. Pero aparece una pregunta incómoda: ¿quién verifica al verificador?
Podemos construir:
Agente
  ↓
Decisión
  ↓
Evidencia
  ↓
Auditor
  ↓
Resultado
Y sentirnos bastante tranquilos.
Hasta que descubrimos que el auditor tiene un bug.
Esto es importante porque introduce un nivel adicional:
Nuestra infraestructura de verificación también necesita ser verificada.
Podemos tener todos los logs del mundo y aun así interpretarlos mal.
Por ejemplo:
Evento A
     ↓
Evento B
     ↓
Auditor
     ↓
"No están relacionados"
cuando en realidad sí pertenecen a la misma ejecución y simplemente estamos utilizando una clave de correlación incorrecta.
La lección es poderosa:
Los datos pueden ser correctos y nuestra interpretación de esos datos puede ser incorrecta.
10. 1.500 tests pasando tampoco significa que todo esté bien
Este problema también aparece en testing.
Podemos tener cientos o miles de pruebas pasando y descubrir un error en producción.
¿Por qué?
Porque podemos estar probando una representación simplificada del sistema real.
Por ejemplo:
Test
 ↓
Mock
 ↓
OK
mientras que:
Producción
 ↓
Restricción real
 ↓
FAIL
La cantidad de tests no es suficiente.
La pregunta importante es:
¿Qué propiedad del sistema estoy demostrando con este test?
Esto es especialmente relevante para gobernanza.
No basta con probar:
"El botón de aprobación funciona."
Tenemos que probar:
"Sin la aprobación requerida,
la acción realmente no puede ejecutarse."
Eso es mucho más cercano a una garantía real.
11. Las políticas deben ser ejecutables
Supongamos que nuestra documentación dice:
"Los cambios en producción requieren aprobación."
Perfecto.
Pero nuestro pipeline permite:
git push
   ↓
deploy
sin comprobar ninguna aprobación.
Entonces tenemos una política documentada, pero no una política efectiva.
Una política realmente importante debería poder convertirse en una regla ejecutable:
Cambio
  ↓
Pipeline
  ↓
¿Cumple política?
   ↙      ↘
 Sí       No
 ↓         ↓
Deploy   BLOCK
La diferencia es enorme.
Una política escrita expresa una intención.
Una política ejecutada por el sistema controla el comportamiento.
Y cuanto más autónomos sean nuestros agentes, más importante será esta distinción.
12. También tenemos que guardar nuestros errores
Normalmente almacenamos el conocimiento actual:
"Esta es la forma correcta de hacerlo."
Pero también sería útil conservar:
"Esta era nuestra hipótesis anterior."
"Esto fue lo que observamos."
"Esto la contradijo."
"Por eso cambiamos."
Por ejemplo:
Hipótesis
   ↓
Evidencia
   ↓
Decisión
   ↓
Falsificación
   ↓
Nuevo conocimiento
Esto es especialmente importante para los agentes.
Si descubrimos que una determinada estrategia falla bajo ciertas condiciones, no queremos que el siguiente agente vuelva a descubrirlo desde cero.
Queremos que pueda recuperar:
"Esta estrategia se utilizó anteriormente y falló cuando X estaba presente."
Los errores dejan de ser simplemente errores.
Se convierten en memoria institucional.
13. El objetivo no es hacer más. Es aprender más rápido.
Aquí creo que está el verdadero cambio de paradigma.
La primera generación de sistemas de IA buscaba:
Pregunta
   ↓
Respuesta
Los sistemas agentic buscan:
Objetivo
   ↓
Plan
   ↓
Herramientas
   ↓
Acciones
   ↓
Resultados
Pero podemos ir un paso más allá:
Trabajo
   ↓
Agente
   ↓
Resultado
   ↓
Verificación
   ↓
Aprendizaje
   ↓
Mejor conocimiento
   ↓
Mejor agente
   ↓
Mejor resultado
       ↺
Aquí la IA deja de ser únicamente una herramienta de producción.
Empieza a convertirse en parte del sistema de aprendizaje de la organización.
14. Una arquitectura de referencia
Si juntamos todas estas ideas, podemos imaginar una arquitectura bastante sencilla:
                         ┌──────────────┐
                         │    HUMANO    │
                         └──────┬───────┘
                                │
                         decisiones críticas
                                │
                                ↓
┌──────────────┐        ┌──────────────┐
│  CONTEXTO Y  │ ─────→ │    AGENTE    │
│ CONOCIMIENTO │        └──────┬───────┘
└──────────────┘               │
                               ↓
                       ┌───────────────┐
                       │ HERRAMIENTAS  │
                       │ Y CAPACIDADES │
                       └───────┬───────┘
                               ↓
                       ┌───────────────┐
                       │ GOBERNANZA Y │
                       │ AUTORIZACIÓN  │
                       └───────┬───────┘
                               ↓
                             ACCIÓN
                               ↓
                           EVIDENCIA
                               ↓
                         VERIFICACIÓN
                               ↓
                            LEDGER
                               ↓
                          APRENDIZAJE
                               │
                               └────────→ CONTEXTO
Cada componente responde una pregunta diferente.
Contexto
¿Qué sabemos y qué ocurrió?
Herramientas
¿Qué puede hacer el agente?
Gobernanza
¿Qué está autorizado a hacer?
Evidencia
¿Cómo sabemos qué ocurrió?
Verificación
¿Podemos confiar en el resultado?
Ledger
¿Podemos reconstruirlo después?
Aprendizaje
¿Qué deberíamos hacer diferente la próxima vez?
15. ¿Cómo lo llevaría a producción?
Y aquí está la parte práctica.
No empezaría construyendo una plataforma gigantesca de agentes.
Empezaría mucho más simple.
Fase 1 — Agente + contexto
Un agente que pueda recuperar información confiable.
Agente
 ↓
Knowledge
 ↓
Contexto
Fase 2 — Herramientas
Definir claramente qué puede hacer.
Agente
 ↓
Tools
 ↓
APIs
Fase 3 — Autorización
Decidir qué herramientas puede utilizar y bajo qué condiciones.
Agent
 ↓
Policy
 ↓
Tool
Fase 4 — Evidencia
Registrar las acciones importantes.
Action
 ↓
Evidence
 ↓
Audit
Fase 5 — Verificación
Comprobar automáticamente los resultados cuando sea posible.
Action
 ↓
Result
 ↓
Verifier
Fase 6 — Autonomía gradual
Permitir más autonomía solamente cuando exista evidencia suficiente.
Manual
  ↓
Approval
  ↓
Supervised
  ↓
Autonomous
Fase 7 — Aprendizaje
Capturar lo que funcionó y lo que no.
Execution
 ↓
Verification
 ↓
Learning
 ↓
Knowledge
Y volver a comenzar.
Conclusión
Creo que estamos entrando en una etapa donde construir un agente ya no significa simplemente elegir un buen modelo y conectarlo a algunas herramientas.
El verdadero desafío aparece cuando queremos que ese agente pueda actuar en el mundo real.
En ese momento necesitamos responder preguntas mucho más difíciles:
¿Qué sabe?
¿De dónde lo sabe?
¿Qué puede hacer?
¿Qué está autorizado a hacer?
¿Por qué confiamos en él?
¿Qué evidencia produjo?
¿Quién verifica esa evidencia?
¿Cuándo necesitamos a un humano?
¿Qué aprendimos después de equivocarnos?
Y todas esas preguntas nos llevan a una conclusión:
La autonomía no es el punto final de la arquitectura agentic.
Es una consecuencia de haber construido suficiente contexto, confianza, evidencia, gobernanza y mecanismos de verificación.
Podemos resumirlo así:
             CONTEXTO
                 ↓
            CAPACIDADES
                 ↓
           AUTORIZACIÓN
                 ↓
              ACCIÓN
                 ↓
             EVIDENCIA
                 ↓
           VERIFICACIÓN
                 ↓
            CONFIANZA
                 ↓
            AUTONOMÍA
                 ↓
           APRENDIZAJE
                 │
                 └──────────→ CONTEXTO
Y quizá el objetivo final no sea conseguir que la IA haga todo por nosotros.
Quizá sea algo mucho más interesante:
Construir organizaciones que sean mejores cada vez que hacen algo.
Una organización donde los agentes no solamente producen resultados, sino que ayudan a conservar el contexto, aprender de los errores, verificar las decisiones y aumentar gradualmente su autonomía.
Porque al final, el verdadero salto no es pasar de:
humano → IA
sino pasar de:
IA que responde
a:
sistemas que actúan, verifican y aprenden.